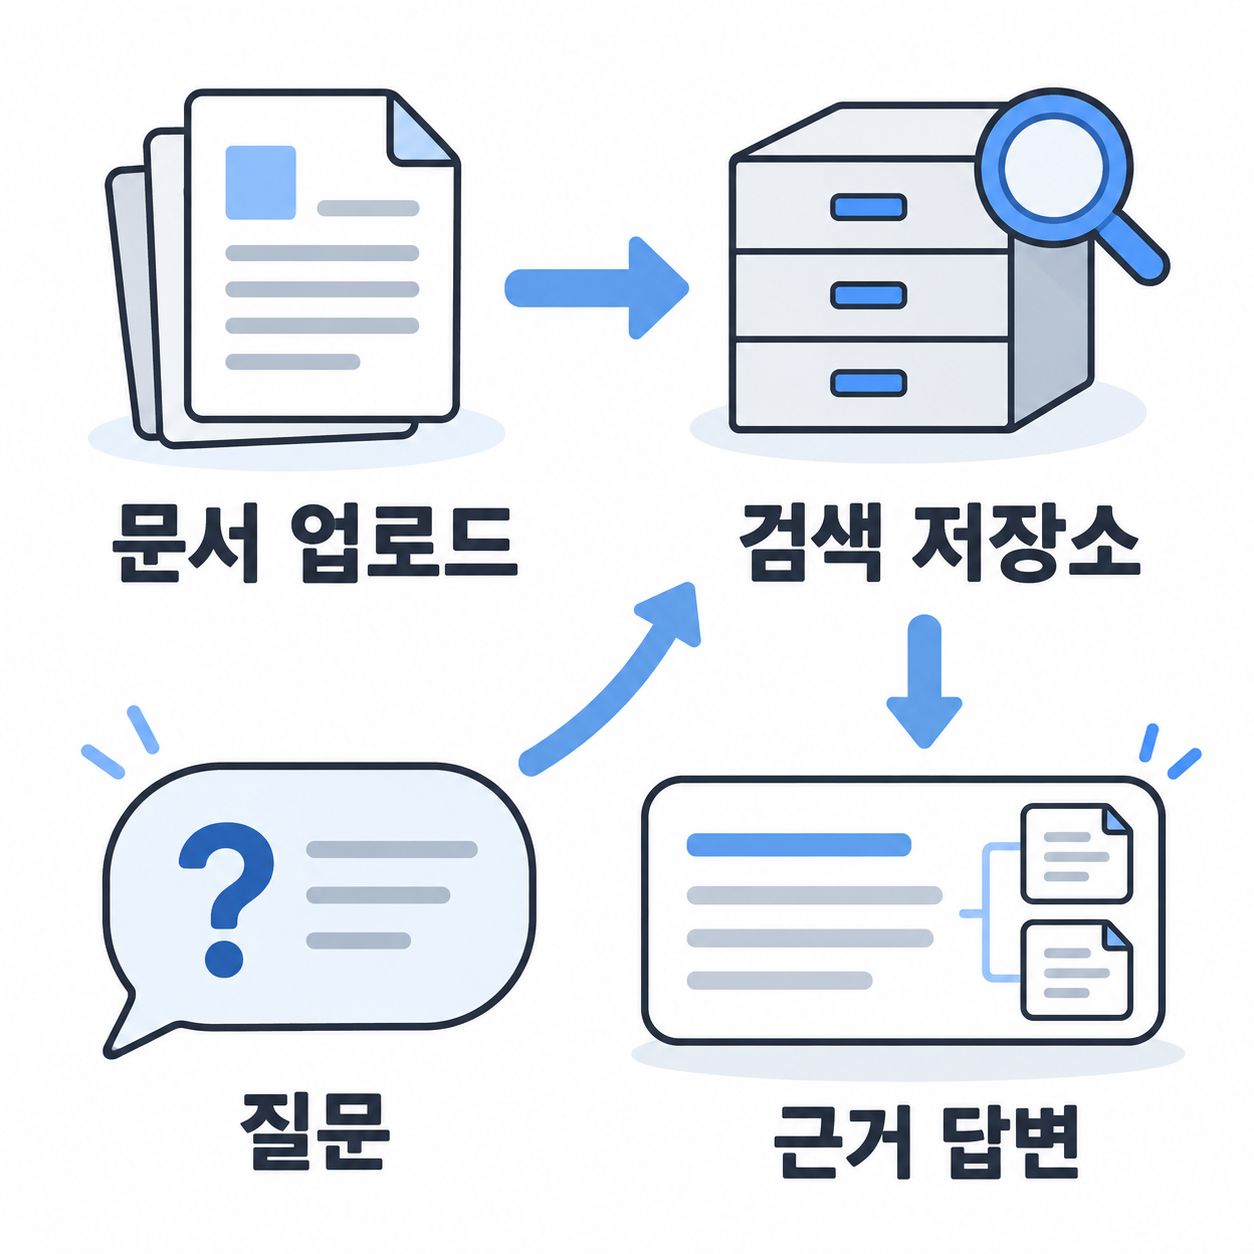
Gemini File Search는 업로드한 문서를 분할·색인하고, 질문과 관련된 내용을 찾아 답변의 근거로 사용하는 도구입니다. 저장소 생성 → 문서 업로드 → 처리 성공 확인 → 저장소 지정 질의 순서로 연결합니다.
Google 공식 문서의 Python 흐름을 바탕으로 작성했으며, 아래 코드는 실제 API 호출로 실행 검증하지 않은 예제입니다.
주요 용어
용어이 글에서의 의미
| RAG | 검색한 자료를 모델의 답변 생성 문맥에 넣는 방식 |
| File Search Store | 검색할 문서 데이터를 관리하는 저장소 |
| 임베딩 | 문서의 유사성을 검색하는 데 쓰는 수치 표현 |
| Operation | 업로드·가져오기 같은 비동기 작업의 상태 |
1. SDK와 테스트 문서 준비
Python 환경에서 다음 명령으로 SDK를 설치합니다. 인증은 Google의 「Using Gemini API keys」 안내에 따라 GEMINI_API_KEY 환경변수에 발급받은 키를 설정합니다. Windows 시스템 환경변수를 바꿨다면 새 터미널을 여세요. GOOGLE_API_KEY도 설정돼 있으면 그 값이 우선하므로 사용할 키를 확인합니다.
pip install -U google-genai실행 폴더에 UTF-8 텍스트 파일 sample.txt를 만들고, 테스트용 문장으로 “테스트 서비스의 고객 문의 시간은 평일 오전 10시부터 오후 5시까지입니다.”를 넣습니다. 실제 내부 문서를 넣기 전에는 업로드 권한과 데이터 처리 정책을 확인하세요.
2. 업로드부터 질의까지 연결
다음 코드를 search_demo.py로 저장하고 같은 폴더에서 python search_demo.py로 실행하는 구성입니다. 모델 이름·저장소 설정·응답과 인용 필드는 기준일의 공식 File search 문서 첫 Python 예제와 대조했습니다. 계정별 사용 가능 여부와 SDK 최소 버전은 검증하지 않았습니다.
import time
from google import genai

client = genai.Client()
store = client.file_search_stores.create(config={
    "display_name": "document-demo",
    "embedding_model": "models/gemini-embedding-2",
})
print("저장소 식별자:", store.name)

op = client.file_search_stores.upload_to_file_search_store(
    file="sample.txt",
    file_search_store_name=store.name,
)
deadline = time.monotonic() + 300
while not op.done:
    if time.monotonic() >= deadline:
        raise TimeoutError("처리 상태를 다시 확인하세요.")
    time.sleep(5)
    op = client.operations.get(op)
if op.error:
    raise RuntimeError(str(op.error))

result = client.interactions.create(
    model="gemini-3.8-flash",
    input="문서에 적힌 고객 문의 시간을 알려 주세요.",
    tools=[{
        "type": "file_search",
        "file_search_store_names": [store.name],
    }],
)
for step in result.steps:
    if step.type != "model_output":
        continue
    for block in step.content:
        if block.type == "text":
            print(block.text)
            for ref in block.annotations or []:
                if ref.type == "file_citation":
                    print("근거:", ref.file_name, ref.source)
300초 대기는 이 예제에서 정한 제한이며 서비스 처리시간 보장이 아닙니다. 시간이 초과돼도 서버 작업이 취소되는 것은 아닙니다. 재실행하면 저장소가 새로 생기므로 출력된 식별자를 보관하세요.
3. 완료 상태와 답변 근거 확인
Google의 「File Search Stores」 API 참조에서 done은 작업 종료를 뜻합니다. done 확인 뒤 error도 검사해야 실패한 업로드를 성공으로 취급하지 않습니다. 저장소의 activeDocumentsCount, pendingDocumentsCount, failedDocumentsCount는 문서 처리 상태를 구분하는 데 사용합니다.
표시명인 display_name과 실제 식별자인 store.name도 다릅니다. 다음 질의부터는 보관한 식별자를 file_search_store_names에 넣어 기존 저장소를 지정합니다. Files API에 이미 올린 파일을 쓴다면 저장소로 가져오는 importFile 단계가 필요합니다.
답변이 출력되면 원문의 문의 시간과 대조하세요. 코드의 annotations는 파일 인용을 확인하는 자리입니다. 인용이 붙었다는 사실만으로 답변 전체의 정확성이 보장되지는 않습니다.
보관 기간과 비용
Google File search 안내에 따르면 Files API 원본은 48시간 뒤 삭제되지만 검색 저장소 데이터는 수명이 다릅니다. 원본 만료를 저장소 삭제로 이해하면 안 됩니다. 임베딩의 보관에는 수동 삭제와 모델 폐기 조건이 있으므로 영구 보관을 전제하지 마세요.
저장과 질의 시 임베딩 생성은 무료이며, 처음 색인할 때의 임베딩과 모델의 입력·출력에는 비용이 발생합니다. 가격과 모델 지원은 실제 사용 직전에 공식 문서에서 다시 확인해야 합니다.
먼저 짧은 테스트 문서 한 개로 답변과 인용을 대조한 뒤 문서 범위를 늘리세요. 이 예제의 한글 검색 품질과 응답 지연은 측정하지 않았습니다.
참고 링크
'AI' 카테고리의 다른 글
| Claude Code Skills 만들기 SKILL.md로 반복 작업을 명령으로 등록하기 (0) | 2026.10.19 |
|---|---|
| Claude Code 유휴 시간 압축 설정 /config에서 Idle compaction 켜고 끄기 (0) | 2026.10.18 |
| Gemini URL Context 사용법: 웹페이지 비교와 URL 조회 상태 확인 (0) | 2026.10.16 |
| Claude API 도구 입력 스트리밍 ㅡ partial_json 조립과 오류 처리 (0) | 2026.10.15 |
| Claude Code /rewind 사용법: 코드 대화 복구 범위와 한계 (0) | 2026.10.14 |