주요 용어 정의
용어정의
| 컨텍스트 캐싱 | 입력 연산 결과를 보관해 비용과 응답 지연을 줄이는 기술 |
| 구조화된 출력 | 스키마 규격 정형 데이터 생성을 강제하는 제약 디코딩 기술 |
| 최소 캐시 토큰 | 캐시 생성 최소 기준으로 Gemini 2.5 Flash는 2,048토큰 |
도입
대용량 문서에서 정보를 추출할 때 입력 토큰 비용 누적과 비정형 출력의 규격 불일치가 발생합니다.
2026-09-27 기준 최신 Google GenAI SDK는 컨텍스트 캐싱과 구조화된 출력을 함께 제공합니다. 대용량 입력을 캐시하고 Pydantic 스키마를 결합하면 구문 오류를 방지하며 저비용으로 정형 데이터를 추출할 수 있습니다.
배경 및 연동 구조
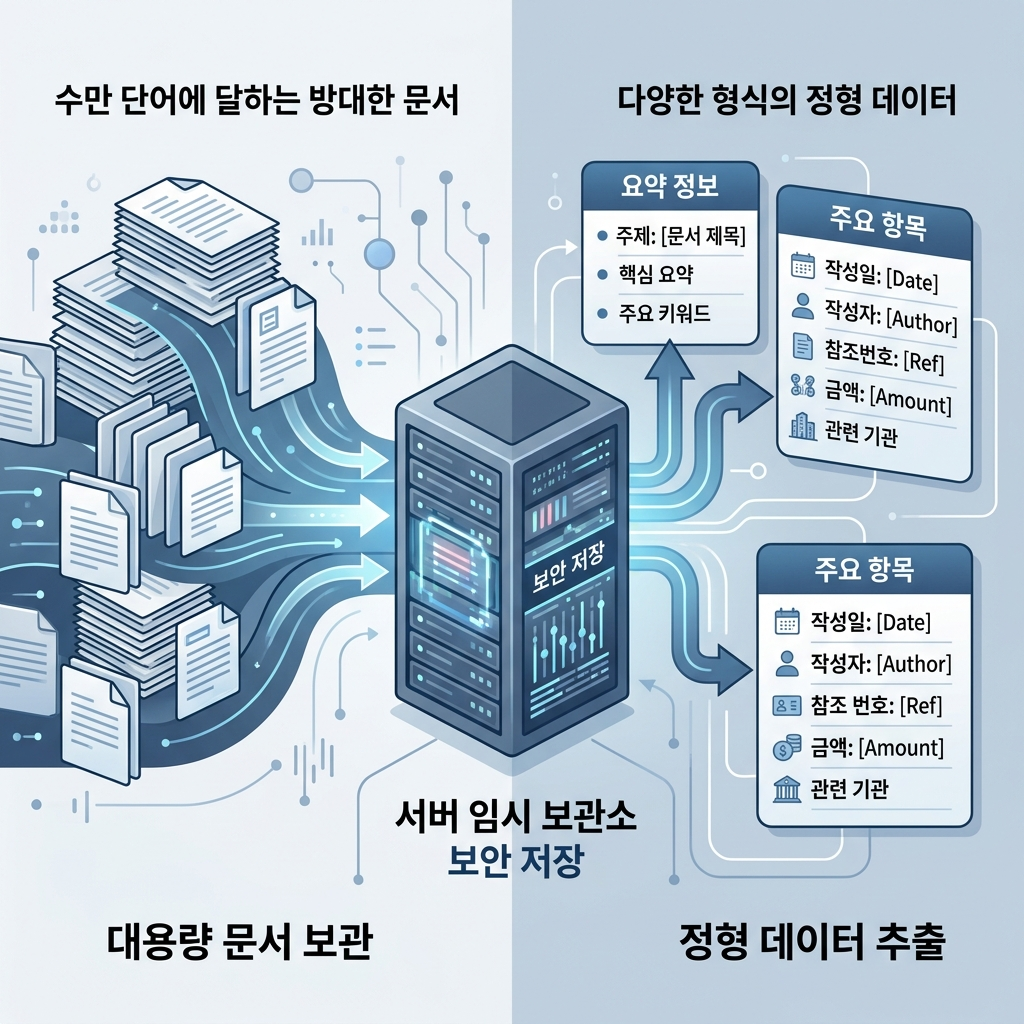
효율적인 추출을 위해 캐시 생성과 질의 요청의 역할을 분리합니다.
입력 문서는 캐시에 보관하고, 출력 스키마는 호출 시 주입합니다. 단일 캐시로 여러 목적의 스키마 질의를 유연하게 처리할 수 있습니다.
[대용량 문서 (최소 토큰)] ──▶ 캐시 생성 ──▶ [컨텍스트 캐시]
                                             │
                       ┌─────────────────────┴─────────────────────┐
                       ▼                                           ▼
              [요약 질의] ──▶ 객체 1                      [위험도 질의] ──▶ 객체 2
핵심 내용: 단계별 연동 실전 구현
최신 google-genai SDK 기반의 추출 코드 패턴입니다.
*(본 코드는 Google GenAI 공식 SDK 명세를 따른 미검증 설계 예제입니다.)*
from google import genai
from google.genai import types
from pydantic import BaseModel, Field

class Summary(BaseModel):
    title: str = Field(description="제목")
    points: list[str] = Field(description="요약 항목")
    risk: str = Field(description="위험도")

client = genai.Client()

# 1. 문서 캐시 생성 (Gemini 2.5 Flash 기준 2,048 토큰 이상)
cache = client.caches.create(
    model="gemini-2.5-flash",
    config=types.CreateCachedContentConfig(contents=[doc_text], ttl="3600s"),
)

# 2. 캐시 참조 및 구조화된 출력 요청
response = client.models.generate_content(
    model="gemini-2.5-flash",
    contents="문서 요약과 위험도를 추출하세요.",
    config=types.GenerateContentConfig(
        cached_content=cache.name,
        response_mime_type="application/json",
        response_schema=Summary,
    ),
)

result: Summary = response.parsed
print(result.title, result.risk)
cached_content로 캐시를 참조하고 response_schema에 모델을 넘깁니다. 생성 결과는 response.parsed를 통해 타입 인스턴스로 변환됩니다.
실제 적용과 한계
두 기능을 결합하면 반복 호출 대비 효율이 개선됩니다.
항목일반 호출캐싱 + 구조화된 출력절감 효과
| 입력 비용 | 전액 정가 청구 | 캐시 할인 단가 적용 | 최대 75~90% 절감 |
| 첫 토큰 대기 | 전체 문서 재연산 | 사전 연산 캐시 참조 | 응답 대기 단축 |
| 출력 형식 | 파싱 에러 위험 | 제약 디코딩 규격 강제 | 구문 오류 방지 (검증 필요) |
실무 적용 시 다음 제약 사항과 운영 기준을 점검해야 합니다.
- 모델별 최소 토큰 확인: 캐시 생성에는 최소 입력 토큰 요건이 있습니다. Gemini 2.5 Flash는 2,048토큰, 모델별로 최대 32,768토큰 차이가 납니다 (공식 캐싱 가이드). 미달 시 400 Bad Request가 나므로 client.models.count_tokens로 점검해야 합니다.
- 캐시 저장 비용: Gemini 2.5 Flash 저장 요금은 1백만 토큰당 시간당 $1.00입니다 (공식 가격표). 저장비가 부과되므로 재사용 빈도가 높은 작업에서 절감 효과가 극대화됩니다.
- 의미 검증과 예외 처리: 구조화된 출력은 스키마 준수는 강제하나 값의 의미적 정확성은 보장하지 않습니다 (공식 구조화 가이드). 안전 차단, 토큰 잘림, API 오류에 대비한 예외 처리와 검증이 필수적입니다.
- TTL 만료 대응: 수명이 지나면 404 NOT_FOUND가 나므로 만료 시 자동 재생성하는 지연 재생성(Lazy Recreation) 로직을 권장합니다.
마무리
대규모 문서를 다루는 LLM 파이프라인은 입력은 캐싱으로 비용을 줄이고, 출력은 스키마로 형식을 구조화하는 것이 핵심입니다.
단일 캐시에 다양한 Pydantic 모델을 결합하면 인프라 비용 절감과 정형 규격 준수를 체계적으로 구현할 수 있습니다.
반복 질의할 문서가 있다면 토큰 수를 점검한 뒤, 모델의 최소 캐시 요건(Gemini 2.5 Flash 기준 2,048토큰)을 충족하는 대상부터 캐싱 연동을 적용해 보세요.
참고 자료
'AI' 카테고리의 다른 글
| Codex CLI 비대화형(Headless) 실행 가이드 ㅡ codex exec와 JSON 스트림 파이프라인 구축 (0) | 2026.09.27 |
|---|---|
| GPT-6 아스트라 vs GPT-5.6: 토큰 가격이 2.5배여도 쓸 만한 작업은? (0) | 2026.09.20 |
| GPT-6 아스트라 가격 계산: 272K 장문 입력 할증과 캐시 비용까지 (1) | 2026.09.19 |
| GPT-6 아스트라 105만 토큰 컨텍스트의 함정 ㅡ 비용·캐시·컴팩션 설계 (0) | 2026.09.18 |
| GPT-6 아스트라 API 사용법: GPT-5.6에서 바뀐 설정과 마이그레이션 예제 (0) | 2026.09.17 |